Что именно продают под видом «настоящего AI»
Есть в русскоязычном AI-инфополе один набирающий обороты тезис, который звучит примерно так: «Хватит пользоваться чатом. Настоящий AI начинается тогда, когда ты поднимаешь собственный harness, подключаешь API моделей, память, инструменты и агентов». Дальше обычно идёт драматургия перехода: вот, мол, ты сидишь в примитивном окошке ChatGPT и набираешь текст, как секретарша, а вот — человек будущего, который собрал свой runtime, дал агенту ключи от всех систем и ушёл пить кофе.
Звучит красиво. Проблема одна: в этом противопоставлении почти никогда не уточняется, что именно с чем противопоставляется.
Присмотритесь к тому, кто это говорит. Очень часто за очередным видео или статьёй про «создай свой harness» обнаруживается конкретный товар: API-прослойка, SaaS для агентов, proxy к моделям, no-code конструктор или open-source проект, которому позарез нужно распространение. Коммерческая мотивация здесь не скрывается — она лежит на поверхности. Но даже если честно вынести её за скобки, остаётся более интересный и куда менее удобный вопрос: а сам-то тезис — верный?
Пользователю предлагают отказаться от ChatGPT как от «обычного чата» и перейти к какому-нибудь OpenClaw, Hermes или собственноручно собранному runtime. Подразумевается, что это переход на другой архитектурный уровень: с «просто разговора с моделью» на «настоящую агентную систему».
Вот только ChatGPT — это давно не окно ввода текста поверх модели.
Посмотрим на то, что уже есть внутри этого «обычного чата»: orchestration — маршрутизация и координация вызовов; context management — сборка контекста под конкретный запрос; tool calling — вызов инструментов; память, которая помнит факты о пользователе между сессиями; доступ к файлам и их анализ; веб-поиск; генерация изображений; session state; permissions; safety policies; model routing — выбор модели под задачу; пользовательский интерфейс; и, наконец, agentic execution loops — тот самый агентный цикл «сделай — посмотри на результат — реши, что делать дальше», который встроен в deep research и в унифицированный агентный режим ChatGPT.
То есть перед нами — все признаки той самой системы, которую продавцы «настоящего AI» предлагают вам собрать самостоятельно. Перед нами уже harness.
Отсюда и рождается главный вопрос этой статьи: если ChatGPT — это уже harness, то чем тогда принципиально отличается собственный harness? И не является ли лозунг «перестань пользоваться чатом, создай harness» ответом на вопрос, который некорректно поставлен?
Откуда этот разговор взялся именно сейчас — тоже не случайно. За последние пару лет открытые агентные harness перестали быть экспериментами и стали продуктами, которые реально можно поставить себе за вечер. OpenClaw вырос из проекта Clawdbot/Moltbot в один из самых быстрорастущих open-source репозиториев, распространяемый как локальный персональный агент с интерфейсом через привычные мессенджеры. Nous Research выпустила Hermes Agent — self-hosted агента с постоянной памятью, самосоздаваемыми навыками и подключением к Telegram, Discord и Slack. OpenAI открыла исходники Codex CLI — терминального агента для работы с кодом. Всё это породило понятное ощущение: «вот, всё уже можно, осталось только собрать». Ощущение это, в общем, верное — собрать действительно можно. Вопрос в том, что именно вы соберёте и что оно даст вам сверх того, что уже лежит в коробке с подпиской.
Три слоя: Model, Harness, Product
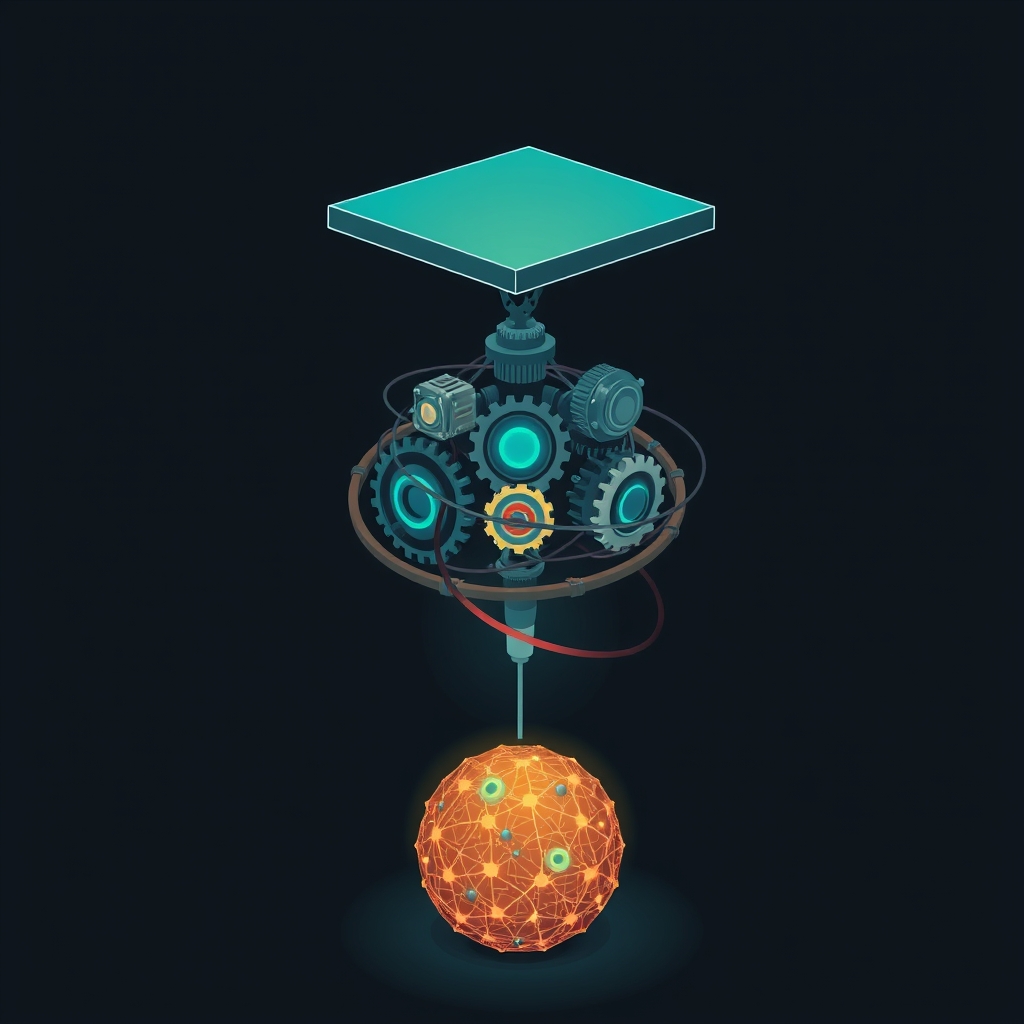
Чтобы говорить предметно, разведём понятия. В любой AI-системе, которая делает что-то полезное, есть три архитектурных слоя:
text (chat) Model
↓
Harness / Runtime
↓
Product / Interface
Model — это сама языковая модель. GPT, Claude, DeepSeek, Qwen, Llama. Она получает на вход контекст и выдаёт следующее порождение — текст, токены, вызов инструмента. Сама по себе модель не является ни ChatGPT, ни Codex, ни Hermes. Это двигатель: без всего остального он умеет только предсказывать следующий токен.
Harness — это система, которая «запрягает» модель в полезную работу. Именно здесь живёт всё интересное: сборка контекста (что именно подать модели, чтобы она ответила по делу), хранение состояния, предоставление инструментов, управление вызовами модели, реализация retry при сбоях, workflow, управление памятью, раздача разрешений на доступ к чему-то, запуск внешних действий, анализ результата и решение, продолжать ли агентный цикл.
Product — это пользовательская форма доступа к harness: веб-чат, CLI, расширение для IDE, мобильное приложение, API, consumer событий, cron-worker.
И вот ключевой момент, который теряется в лозунге: «чат» — это чаще всего только интерфейс. Третий слой. Форма, в которой вы видите результат. Под ним всегда стоит harness, а под ним — модель.
text ChatGPT UI
↓
ChatGPT Harness
↓
LLM
У Codex то же самое, только интерфейс другой:
text CLI / IDE / UI
↓
Codex Harness
↓
LLM
У Hermes:
text CLI / Web / Events
↓
Hermes Harness
↓
LLM
Три разных продукта. Три разных набора инструментов. Три разных владельца и три разных модели эксплуатации. Но архитектурная структура одна и та же: интерфейс поверх harness, harness поверх модели.
Из этого следует простой и неудобный для авторов лозунга вывод: утверждение «чат — это не harness» архитектурно некорректно. Чат — это одна из обёрток вокруг harness. Говорить «у меня не чат, а harness» — это как гордиться тем, что у тебя не окно, а комната: и то и другое находится внутри одного здания, вопрос лишь в том, кому принадлежит здание и у кого ключи.
Переопределяем противопоставление
Раз «чат vs harness» отпадает, надо найти корректную оппозицию. Она звучит так:
text Managed Harness vs Self-Managed Harness
Разница не в том, есть ли harness. Разница в том, кто им управляет.
Managed harness — это ChatGPT. Провайдер решает почти всё: какая модель (точнее, какой набор моделей и как они маршрутизируются) стоит под капотом, как собирается контекст, как устроена память, какие инструменты доступны, какие разрешения у системы, когда выходят обновления, какой интерфейс вы видите, как устроена часть агентного цикла, где крутится инфраструктура, как она масштабируется, как ведётся наблюдаемость и какие наложены ограничения. Вы получаете готовый продукт и не занимаетесь его эксплуатацией.
Цена этого — вы не управляете ничем из перечисленного!
Self-managed harness — это Hermes, OpenClaw или собственный runtime. Здесь решаете вы: какие модели использовать, какие инструменты предоставить агенту, что хранить, как строить память, какие workflow запускать, какие данные отправлять во внешние API, где выполнять inference, когда подключать локальные модели, какие permissions дать, как делать retries, как обрабатывать ошибки и как обновлять систему.
Цена этого — вы же всё это и сопровождаете!
Обратите внимание: никто в этой паре не «без harness». Вы не отказались от harness, когда ушли с ChatGPT на OpenClaw. Вы поменяли его владельца. И весь настоящий инженерный разговор — не про «чат против агентов», а про то, какие последствия несёт смена владельца. Вот эти последствия и стоит разобрать честно, по обе стороны.
Что вы реально получаете, собирая harness самостоятельно?
Сторонники «своего AI» любят сводить аргумент к одному слову — «контроль». Это правда, но слишком крупная правда, чтобы ей пользоваться. Контроль бывает разный, и за каждый его вид вы платите отдельно. Разберём по слоям.
Контроль контекста. В managed-чате вы не управляете тем, как система собирает контекст. Вы видите окно ввода и ответ; что именно попало модели на вход, в каком порядке и в каком объёме — вы не знаете и повлиять на это можете лишь косвенно. В собственном harness, сборка контекста становится явной частью архитектуры. Вы сами задаёте, что входит в контекст:
text system policy
- user profile
- project state
- relevant documents
- previous decisions
- last messages
- tool outputs
- retrieved memory
- …
И вот это — контекст инжиниринг — уже не «промпт-инжиниринг в окне чата», а полноценная инженерная дисциплина. Вы решаете, что модель «видит» перед каждым шагом, а значит, управляете и качеством, и стоимостью каждого вызова, и утечками данных.
Собственная модель памяти. Это, пожалуй, главная тема всего спора. В продукте вроде ChatGPT память — это предоставляемая функция: она есть, она настраивается парой переключателей, и на этом ваши возможности заканчиваются. В собственном harness память может стать полноценной информационной системой:
text Memory ├── User ├── Projects ├── Decisions ├── Facts ├── Conversations ├── Tasks ├── Documents └── Temporary Working State
И вот тут важна тонкость, которую почти все пропускают: ценность памяти определяется не её объёмом, а политикой извлечения данных (retrieval policy) — правилом, по которому решается, что именно попадёт в следующий контекст. Складировать в векторную базу всё подряд — тривиально. Трудно — и дорого — решить, какой факт сейчас релевантен, а какой будет только мешать модели и жечь токены. Управляемая память — это не «я сохраняю», а «я умею вовремя извлекать нужное».
Собственные инструменты. Вы можете дать агенту доступ к тому, что действительно составляет вашу работу: Git, CI/CD, Jira, PostgreSQL, Kafka, WordPress, SSH, Kubernetes, внутренние API, observability, документационные репозитории, собственные бизнес-функции. И тогда AI перестаёт быть внешним сервисом, к которому вы ходите с вопросами, и становится частью вашей инфраструктуры. Это принципиально другое положение: из консультанта за стеклом агент превращается в компонент системы, у которой есть ваш контекст, ваш доступ и ваши данные.
Model routing. В managed-продукте вы берёте ту модель, которую вам дали, — даже если «под капотом» их несколько, маршрутизацией управляете не вы. В собственном harness маршрутизация — ваше решение:
text classification → локальная маленькая модель extraction → DeepSeek complex reasoning → GPT coding → специализированная coding-модель embeddings → embedding-модельОдин и тот же pipeline может дёшево классифицировать вход маленькой локальной моделью, извлекать сущности средней, а глубокий анализ отдавать сильной. Вы оптимизируете сразу четыре вещи: стоимость, задержку (latency), приватность и качество. Ни один managed-продукт не даст вам такой гранулярности просто потому, что его экономика устроена иначе.
Воспроизводимость и привязка к версии (version pinning). Это тот архитектурный плюс, который труднее всего объяснить людям, не побывавшим в производстве ПО (software production). Managed-провайдер может в любой момент изменить внутреннее устройство продукта: обновить модель, поменять способ сборки контекста, переобучить память. Ваш «промпт», который вчера работал, сегодня может работать иначе — и вы даже не узнаете, что именно изменилось. В собственной системе вы фиксируете:
text harness = version workflow + version prompt + version skill + version model + version tool + version embedding + version memory schemaИ можете воспроизвести поведение системы через месяц, через год, на другом железе. Для разовых экспериментов это неважно. Для production AI, где результат должен быть предсказуемым и проверяемым, — это разница между системой и дорогим ритуалом.
Независимость (Data sovereignty). Вы можете хранить данные локально, использовать локальные модели, делать корректировку (redaction) чувствительных полей, отправлять во внешний API только минимально необходимый контекст и разделять чувствительную (sensitive) и не чувствительную (non-sensitive) рабочую нагрузку (workload). Для кого-то это юридическое требование, для кого-то — паранойя, но это реальный, проверяемый контроль, которого managed-продукт не даёт в принципе: отправляя запрос в чужой сервис, вы передаёте данные тому, кто управляет harness.
Event-driven и автономная работа. Вот, пожалуй, единственное отличие, которое действительно выводит self-managed harness за пределы «пользовательского опыта чата». Система, которой вы владеете, может запускаться не от сообщения человека. Она может стартовать от события:
text Kafka event → Agent → Analysis → Tool calls → DB updateИли по расписанию:
text Cron → Research → Evaluation → ReportИли от внешнего триггера:
text GitHub event → Code review agentВ этой картине чат — всего лишь одна из возможных точек входа, и далеко не самая интересная. Managed-продукт в первую очередь оптимизирован под интерактивный диалог с человеком. Self-managed — под работу без человека вообще.
Независимость от конкретной модели. Если архитектура сделана правильно, над моделями у вас лежит слой-адаптер:
text Harness
↓
Model Adapter
↓
GPT Claude DeepSeek Local model
Тогда смена модели — это замена одного адаптера, а не переписывание всей системы. Skills, память, инструменты и workflow остаются вашими. Модели становятся расходным, заменяемым ресурсом, а не фундаментом, на котором всё построено. Это и есть то, что на языке рынка называется «меньше vendor lock-in» — но честнее сказать: вы переносите lock-in с модели на собственную систему, которую сами же и обслуживаете.
Как это выглядит в работе: один сквозной пример
Чтобы не оставаться на уровне перечислений, прогоним один пример — условный контент-конвейер, который собирает источники, отбирает темы и готовит черновики статей.
В managed-чате это делается вручную: вы открываете чат, просите «вот эти источники, сделай обзор», получаете текст, копируете его. Каждый раз — новый разговор, новая сборка контекста, никакой памяти о том, что вы решали на прошлой неделе. Всё держится на вас: вы помните, вы формулируете, вы переносите результат.
В self-managed harness тот же процесс разворачивается в pipeline, который живёт без вас. Сначала классификатор на маленькой локальной модели дешёво отсеивает нерелевантные источники. Потом модель среднего уровня извлекает из выживших, сущности и факты. Тяжёлый reasoning подключается только на этапе «есть ли здесь вообще тема для статьи» — и лишь если ответ положительный, сильная модель пишет черновик. Память при этом не теряется: решения вроде «это мы уже разбирали, не поднимаем снова» лежат в отдельном слое и достаются согласно «политике воспоминаний» (retrieval policy), а не по воле человека, который должен был всё помнить сам.
Заметьте, где здесь выигрыш: не в том, что «модель лучше», а в том, что маршрутизация экономит токены, память экономит повторные решения, а event-driven запуск экономит ваше время — процесс работает по расписанию, пока вас нет. И заметьте, где здесь цена: каждый из этих слоёв надо было написать, отладить и теперь сопровождать. Классификатор, который ошибается, — это ваша ошибка, а не баг провайдера. Память, которая достаёт не то, — это ваша retrieval policy, а не «ChatGPT что-то забыл». Вы купили себе не волшебство, а стек технологий, за который теперь отвечаете.
А теперь — цена этой свободы
До сих пор всё звучало как реклама self-hosted AI. Пора сказать то, о чём молчат почти все, кто продаёт вам «свой harness»: большая часть цены этой свободы остаётся за кадром.
Вы сами становитесь разработчиком ChatGPT. Это, пожалуй, самая точная формулировка всей темы. Новичок заходит в задачу с картиной в голове: «соберу LLM + tools + memory, и готово». Три компонента, вечер работы. А дальше начинается то, что не показывают в роликах про «запусти агента и пей кофе». Довольно быстро появляется auth — как агенту вообще аутентифицироваться в ваших системах. Permissions — что ему можно, а что нельзя. Secrets — где хранить ключи, чтобы их не слить в чат. Tool isolation — чтобы один сбойный инструмент не уронил остальное. Retries и timeouts — потому что внешние API падают. Queues — потому что запросы приходят пачками. Logging, observability, tracing — потому что иначе вы не поймёте, что агент сделал вчера в три часа ночи. Evals — чтобы понять, стал ли он лучше после вашего последнего «улучшения» или хуже. Prompt versioning — потому что промпты теперь ваш код. Cost accounting — потому что каждый лишний токен — это деньги. Caching, model fallback, concurrency, rate limits, human approval gates. Потом UI — потому что гонять агента через терминал удобно не всегда. Потом storage, backup, disaster recovery.
И вот тут наступает неприятное осознание: вы собирались «просто подключить модель», а собрали ещё одну полноценную систему, которую теперь нужно сопровождать. OpenClaw не превращает пользователя во владельца искусственного интеллекта. Он превращает его ещё и в DevOps собственного AI runtime. Свобода от vendor lock-in начинается примерно там же, где начинается ваш собственный backlog.
Есть хороший тест на трезвость. Посчитайте, сколько из перечисленного выше вы готовы написать, а главное — сопровождать годами. Если ответ «всё» — добро пожаловать. Если ответ «ну, это же скучная обвязка, я хотел только интересное» — то вы хотели не harness, вы хотели игрушку, и managed-продукт вам честно продаст её за подписку.
Порог входа: это не только про код!
Отдельно стоит сказать про сам порог входа, потому что в рекламе «своего AI» его систематически занижают. Формально всё верно: подключить модель через API — это несколько строк. Но между «модель ответила» и «система работает над вашими задачами без присмотра» лежит пропасть, которую нельзя перепрыгнуть за вечер, как бы ни обещали ролики.
Self-managed harness требует минимум три компетенции, которых нет в требовании «уметь общаться с ChatGPT». Первая — понимание того, как сам harness устроен: контекст, инструменты, циклы, память. Вторая — операционная дисциплина: вы теперь отвечаете за то, за что раньше отвечал провайдер, и это отдельная работа, а не побочный эффект. Третья — умение отличать «модель ошиблась» от «я неправильно собрал контекст», потому что во втором случае смена модели ничего не починит.
Ничего из этого не является недоступным знанием. Но это именно знание, а не кнопка. И если вам кажется, что вы «просто подключили агента», а он работает плохо, — скорее всего, вы заплатили не за harness, а за доступ к его демо-версии, и настоящая работа ещё впереди.
Security: когда ошибка рассуждения становится инцидентом
Этому нужно уделить отдельное место, потому что именно здесь проходит самая опасная граница между «чатом» и «системой».
Пока LLM только отвечает текстом, её ошибка ограничена плохим ответом. Неверный факт, неудачная формулировка, лишний абзац. Неприятно, но не страшно: вы видите текст, вы его не публикуете, вы его не выполняете.
Всё меняется, когда агент получает реальный доступ:
«text SSH Git Docker Kubernetes Database Email Publishing Cloud APIs «
В этот момент ошибка reasoning перестаёт быть «плохим ответом» и становится operational incident. Модель неверно поняла задачу — и вместо «удали тестовую таблицу» удалила боевую. Неверно прочитала вывод команды — и закоммитила секрет. Приняла инструкцию из документа, который анализировала, за легитимную команду — и выполнила её. Это не фантастика про «взбесившийся ИИ», это ровно тот класс ошибок, который в обычной разработке называется «доверил непроверенному коду прод».
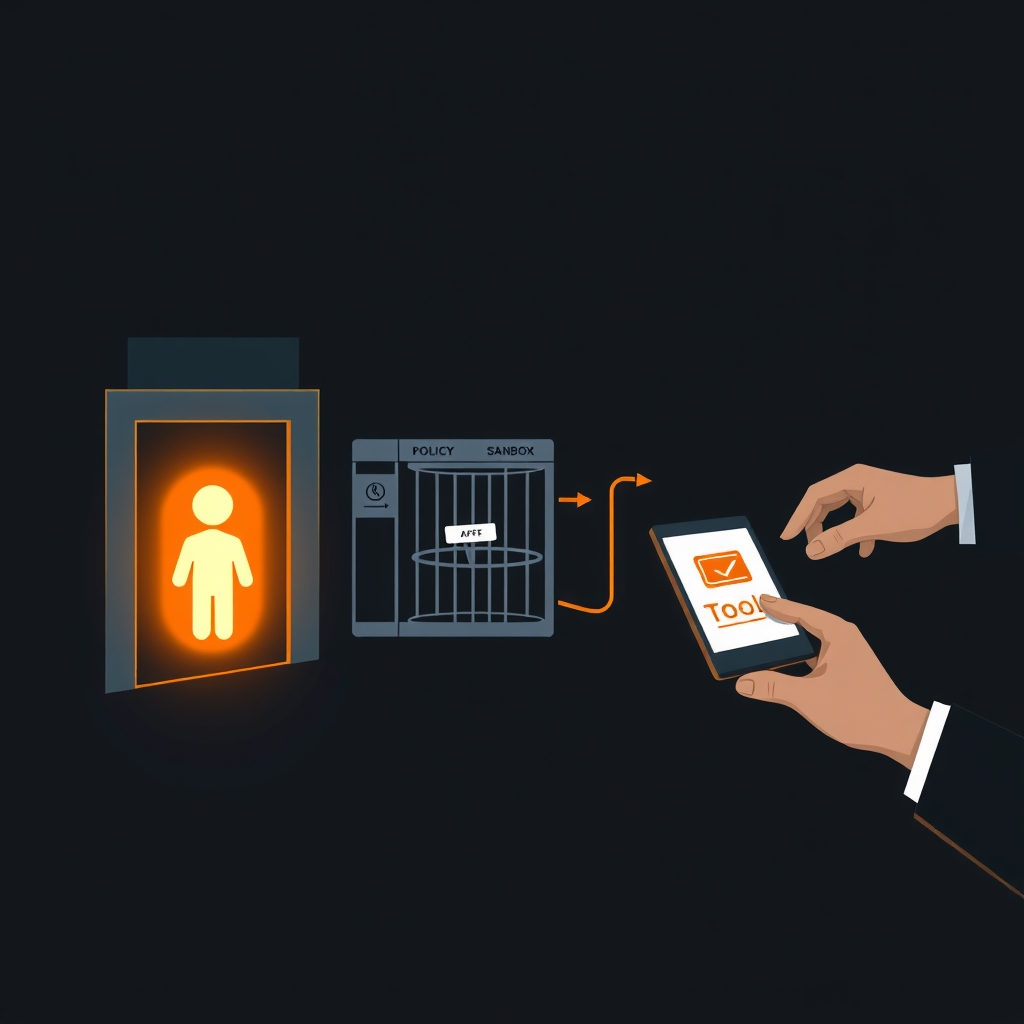
Поэтому зрелый harness не пускает вывод модели напрямую в инструмент. Между ними обязана стоять цепочка:
«text LLM ↓ Policy ↓ Permission Check ↓ Sandbox ↓ Approval Gate ↓ Tool «
Сначала политика: что вообще этой системе позволено. Потом проверка полномочий: имеет ли этот агент, в этом контексте, право на это действие. Потом изоляция: даже легитимное действие выполняется в песочнице, а не в вашем прод-окружении. Потом gate одобрения: для необратимых операций — человек, который смотрит и жмёт «да» или «нет». И только потом — сам инструмент.
Если это кажется вам знакомым — правильно. Это ровно то, что в обычной инфраструктуре называется IAM, identity and access management. Агенту, как и любому другому субъекту доступа, нужны identity, authentication, authorization, scopes, least privilege, audit и separation of duties. Агент с SSH — это уже не чат-бот. Это субъект доступа. И относиться к нему надо соответственно.
Отдельная строка в этом бюджете — prompt injection. Агент, который читает документы, веб-страницы и письма, неизбежно встречает текст, написанный не вами. Модель по своей природе склонна следовать инструкциям, которые находит в контексте, — а значит, любая страница, любой файл и любое письмо потенциально являются кодом, который исполняется в вашей среде. У managed-продукта эту проблему решает провайдер — с переменным успехом, но не вашими силами. У self-managed harness это ваша задача: модель полномочий обязана исходить из того, что всё, что агент прочитал, могло пытаться им управлять. Иначе ваш «безопасный агент» рано или поздно выполнит инструкцию, которую вы ему не давали.
Отсюда простой критерий зрелости: agentic system без модели полномочий — архитектурно незрелая система. Неважно, как хорошо она пишет код или как красиво резюмирует документы. Если она может действовать, но не может доказать, что имела право действовать, — это не продукт, это бомба с зажжённым фитилём, и вопрос лишь в том, когда ошибка рассуждения совпадёт с доступом к чему-то важному.
Как эти две системы ломаются
Есть ещё одно различие, которое редко проговаривают, но которое на практике важнее половины списков выше: managed и self-managed harness ломаются по-разному, и ответственность в этих поломках лежит в разных местах.
Когда ломается managed-продукт, вы получаете уведомление о сбое, страницу статуса и обещание починить. Вам не нужно знать, что именно упало: observability — не ваша забота, дежурный инженер — не вы, восстановление — чужой SLA. Минус в том, что вы при этом ничего не можете сделать — только ждать. И вы не можете зафиксировать «работало до обновления, сломали они», потому что внутренностей не видите.
Когда ломается self-managed harness, вы — и дежурный, и инженер, и служба поддержки. Хорошая новость: починить можно всё. Плохая новость: починить должны вы. А прежде чем чинить, нужно увидеть проблему — и это значит, что observability, логирование и трассировка должны быть заложены с первого дня, а не прикручены задним числом, когда агент уже в третий раз молча сделал не то.
Именно поэтому «у меня свой harness» без логов, метрик и алертов — это не контроль, а иллюзия контроля. Вы не владеете системой, которую не видите. Вы просто несёте за неё ответственность, не имея инструментов, чтобы с ней справляться. Managed-продукт продаёт вам спокойствие вместе с бессилием; self-managed продаёт вам власть вместе с дежурством. Выбор — в том, какую из этих двух неприятностей вы готовы терпеть.
Экономика: разрушим ещё два мифа
В споре «чат или свой harness» экономические аргументы обычно подаются двумя одинаково неверными лозунгами: «подписка всегда дешевле» и «API всегда дешевле». Оба неверны, потому что оба упускают главное — режим использования.
Активный личный пользователь. Если человек часами в день разговаривает с сильной моделью, гоняет её по сложным темам, загружает документы, пользуется deep research и генерацией изображений — фиксированная подписка ChatGPT может быть экстремально выгодна. Считать тут особо нечего: фиксированная цена против платы за токены на интенсивном интерактивном использовании почти всегда в пользу подписки. Плюс вы не платите вообще ничего за инфраструктуру — она включена.
Автоматизированный pipeline. Обратная ситуация: запросов много, но они маленькие, предсказуемые и маршрутизируются между моделями. Классификация на локальной модели почти бесплатна, извлечение на средней — копейки, а тяжёлый reasoning задействуется редко. В таком режиме API плюс локальные модели может выйти заметно дешевле подписки, особенно если система работает круглосуточно и не требует, чтобы ей «сидел человек и разговаривал».
Но настоящая ошибка — считать, что стоимость собственного harness определяется inference. Это не так. Основная стоимость почти всегда спрятана в другом месте:
«text разработка эксплуатация observability debugging security обновления maintenance «
Токены вы оплачиваете по счёту провайдера и видите цифру. А вот часы, которые вы и ваша команда тратите на то, чтобы harness вообще работал, не падал, не сливал секреты и оставался предсказуемым, — это стоимость, которую никто не выставляет в конце месяца, но которая съедает больше, чем кажется на старте. У этого есть честное название: Total Cost of AI Ownership. И пока вы не начали считать его целиком — со всеми часами сопровождения, а не только с токенами, — вы сравниваете цену подписки с ценой API, а надо сравнивать цену подписки с ценой владения системой.
Пять минут на подключение модели легко превращаются в пять месяцев сопровождения платформы. Это не значит, что платформа не нужна. Это значит, что её стоимость надо честно класть в смету, а не прятать за энтузиазмом «ну это же просто API».
Качество системы — это не только модель
Есть ещё одна иллюзия, которую стоит развеять, пока мы здесь: что качество AI-системы определяется качеством модели. Это удобное, но неверное упрощение — и именно оно позволяет продавцам «настоящего AI» внушать, будто разница между ChatGPT и вашим harness в том, что «вы выбираете лучшую модель».
Концептуально качество системы выглядит скорее так:
«text System Quality ≈ Model × Context × Tools × Memory × Workflow × Evaluation «
Заметьте: умножение, а не сумма. Если хотя бы один сомножитель близок к нулю, общий результат падает, как бы силён ни был остальной набор. Сильная модель, которой скормили мусорный контекст, ответит красиво и неверно. Средняя модель, встроенная в систему с хорошей памятью, чистыми инструментами и внятным workflow, может обойти её по практическому результату.
Отсюда неожиданный, но логичный вывод: сильная LLM в плохом harness может работать хуже средней модели в хорошо спроектированной системе. И наоборот — когда люди разочаровываются в «своём агенте», который на GPT отвечает хуже, чем ChatGPT, дело почти никогда не в модели. Дело в том, что у них под рукой оказался голый движок, а все те слои, которые делают ChatGPT удобным, им предстояло построить самим — и они об этом не знали.
Когда собственный harness действительно нужен
Теперь, когда обе стороны разобраны, можно дать честные критерии. Self-managed harness имеет смысл, если вам нужно хотя бы что-то из этого:
- долговременные специализированные workflow, которые крутятся неделями и месяцами;
- автоматическая работа без человека — по событиям, расписанию, триггерам;
- интеграция с внутренними системами: ваша база, ваш Git, ваш CI, ваш корпоративный сервис;
- собственная memory architecture — не «функция памяти», а модель знаний вашей организации;
- model routing — разная модель под разные задачи и бюджеты;
- локальные модели — по цене, приватности или автономности;
- контроль данных — legal, compliance или просто здоровая паранойя;
- event-driven workflow, где система реагирует на мир, а не на сообщение;
- воспроизводимость — зафиксированные версии всего, что влияет на результат;
- строгий audit — вы обязаны доказать, кто и что делал;
- кастомные permissions — потому что ваш агент будет трогать то, что трогать нельзя без разрешения;
- AI как часть production-системы, а не как отдельный сервис, в который ходят люди.
Если в вашем списке есть хотя бы несколько пунктов из этого перечня — вы не «покупаетесь на хайп», вы решаете инженерную задачу, и собственный harness для неё — разумный инструмент.
Когда он совершенно не нужен
И наоборот. Прямо скажем: во многих случаях рекомендация «подними себе OpenClaw» — это не совет, а идеология. Если ваша реальность выглядит так:
- вы обсуждаете идеи;
- пишете тексты;
- исследуете тему;
- анализируете документы;
- иногда пишете код;
- делаете brainstorming;
- пользуетесь веб-поиском для разовых вопросов,
— то готовый ChatGPT, скорее всего, рациональнее. За стоимость подписки вы уже получаете хороший UI, набор моделей, инструменты, работу с файлами, веб, память, мультимодальность и всю инфраструктуру. Вы получаете всё это сегодня, без единой строчки кода и без единого часа сопровождения.
Создавать собственный аналог этого ради идеологии «настоящего AI» — странное инженерное решение. Это примерно как собрать себе операционную систему с нуля, потому что «готовые ОС — это для слабаков». Возможно, вы что-то себе докажете. Но задачу, ради которой всё затевалось, вы решать не будете — вы будете обслуживать систему, которая решает задачу.
Главное, что надо услышать: «я пользуюсь ChatGPT» и «я собрал свой harness» — это не две ступени одного пути, где вторая выше. Это два разных ответа на разные вопросы. Один отвечает на вопрос «как мне быстро поработать с моделью прямо сейчас», другой — на вопрос «как мне встроить AI в мою систему насовсем».
Не обязательно выбирать
Самая распространённая ошибка в этом споре — вера в то, что нужно выбирать что-то одно. Это не так. Реальная архитектура у большинства людей, которым AI вообще нужен по работе, — гибридная:
«text Human / \ / \ ChatGPT Own Harness │ │ interactive work automation reasoning workflows research integrations writing memory agents «
ChatGPT — для интерактивной работы: общение, размышление, исследования, разовые задачи, сложный reasoning, когда вам нужен быстрый диалог с сильной системой и не нужна никакая эксплуатация. Собственный harness — для постоянных процессов: event-driven автоматизация, специализированная память, интеграции, production-агенты, локальная инфраструктура, всё, что должно работать без вас.
Они не обязаны конкурировать. Напротив, они отлично дополняют друг друга именно потому, что оптимизированы под разные режимы. Проблема возникает не тогда, когда вы используете оба, а когда кто-то пытается продать вам один как замену другому.
Если нужен быстрый ориентир вместо таблицы критериев, подойдёт простое правило: спросите себя «кому принадлежит состояние?». Если вся ценность — в диалоге, который происходит сейчас и нигде не сохраняется, вам достаточно managed-чата. Если ценность — в том, что накапливается между диалогами: решения, документы, связи, запущенные процессы, — рано или поздно понадобится что-то, что контролируете вы сами. Граница проходит не между «чатом» и «harness», а между «состояние живёт у провайдера» и «состояние живёт у меня». Всё остальное — детали.
Кратко, для тех, кто любит таблицы:
| Managed harness (ChatGPT) | Self-managed harness | |
|---|---|---|
| Кто решает, что в контексте | провайдер | вы |
| Кто владеет памятью | провайдер | вы |
| Кто выбирает модель | провайдер | вы |
| Кто отвечает за инфраструктуру | провайдер | вы |
| Кто отвечает за безопасность | провайдер (частично) | вы |
| Кто просыпается ночью при сбое | дежурный провайдера | вы |
| Цена | подписка + данные | время + инфраструктура + данные у вас |
| Когда удобно | интерактивная работа | автоматизация и интеграции |
Возражение про лимиты и модерацию
Осталось проговорить самое эмоциональное возражение, которое почти всегда всплывает в этом споре: «но у ChatGPT же лимиты, модерация и цензура, а мой собственный harness — свободный». Здесь важно не запутаться в категориях.
Да, у managed-продукта есть ограничения: что модель готова обсуждать, сколько она может сделать за раз, какие действия ей запрещены. Но это не признак того, что «это просто чат». Это ровно те самые safety policies, о которых шла речь выше: слой harness, который решает, что можно, а что нельзя. Просто в managed-случае эти политики пишет провайдер, а вы получаете их вместе с продуктом.
Переход на собственный harness эту проблему не снимает — он меняет её автора. Свобода от чужой модерации означает ровно одно: теперь политики безопасности пишете вы. Если вы их не напишете, вы получите не «свободного агента», а агента без тормозов — и вся ответственность за то, что он сделает, ляжет на вас. Собственный harness не освобождает от ограничений, он передаёт вам право их устанавливать. А право устанавливать — это ещё и обязанность установить.
Так что противопоставление «ограниченный ChatGPT против свободного harness» — ещё одна версия той же ошибки. Ограничения есть в обеих системах. Вопрос не в том, есть ли они, а в том, кто их пишет и кто за них отвечает.
Вместо вывода: переопределим лозунг
Вернёмся к тому, с чего начали.
«Перестань пользоваться чатом. Создай harness».
Теперь видно, что в этой фразе не так. Она выдаёт различие в интерфейсе за различие в архитектуре. Она называет «чатом» то, что давно является управляемым кем-то другим harness, и обещает «настоящий AI» там, где на самом деле происходит всего лишь смена владельца runtime — с провайдера на вас.
Корректнее было бы сказать так: перестань думать о ChatGPT как о модели. Это уже managed AI harness. Собственный harness нужен не потому, что чат — это якобы игрушка, а потому что иногда тебе требуется другой уровень контроля над памятью, инструментами, моделями, данными и execution flow.
И уж совсем жёстко: если автор противопоставляет ChatGPT и harness как два разных архитектурных класса систем — скорее всего, он либо сознательно упрощает терминологию ради эффектного контента, либо сам не разобрался в архитектуре. Третьего варианта, скорее всего, нет.
Реальное противопоставление выглядит так:
«text Managed AI Runtime vs Self-Managed AI Runtime «
И вот здесь — и только здесь — начинается настоящий инженерный разговор. Не про то, кто «настоящий», а про trade-offs: кто управляет контекстом, кто владеет памятью, кто платит за инфраструктуру, кто отвечает за безопасность и кто просыпается в три часа ночи, когда агент с доступом к проду сделал что-то не то.
Ответ на вопрос «а есть ли вообще противопоставление?» звучит так: есть, но не то, которое вам продают. Не «чат против harness». А «чужой harness против вашего». И выбор между ними — это не выбор между прошлым и будущим. Это выбор между тем, чтобы платить провайдеру за то, чтобы он управлял системой, и тем, чтобы управлять системой самому — вместе со всеми её счетами, дежурствами и backlog’ом.
Что из этого вам нужно — решать не по лозунгу, а по задаче. Потому что harness у вас будет в любом случае. Вопрос только один: чей.