AI-бухгалтер без права на выдумку: как построить управляемую автоматизацию финансовой отчетности
«А если она придумает нам прибыль?»
Почти каждый разговор о внедрении генеративного ИИ в финансы проходит по одному сценарию. Сначала — демонстрация. Модель загружает Excel-файлы дочерних обществ, распознаёт в них статьи отчётности, объясняет, откуда взялась каждая цифра, и выдаёт аккуратную сводную таблицу. Выглядит впечатляюще: три разных формата, десятки строк, минуты вместо нескольких дней ручной работы.
Потом наступает тишина, и кто-то из финансовых директоров задаёт вопрос, ради которого, собственно, все и собрались: «А что будет, если она перепутает 125 миллионов и 152 миллиона? Или потеряет минус? Или — хуже всего — когда данных не хватает, просто придумает недостающую сумму, чтобы таблица сошлась?»
Это не придирка и не технофобия. Это самый точный вопрос, который можно задать про любую систему, использующую вероятностные модели там, где раньше работали человек и учётная программа. И ответ на него — не «значит, никакого ИИ в финансах» и не «модель уже такая хорошая, что ей можно доверять». Ответ в другом: систему нужно спроектировать так, чтобы ошибка модели не могла незаметно превратиться в утверждённый финансовый результат.
Проблема не в том, что LLM ошибается. Ошибаются и люди, и сами учётные системы — вопрос лишь в том, обнаружит ли ошибку кто-то до того, как она попадёт в отчёт, и кто за неё отвечает. Ошибка человека обычно видна и поддаётся разбору: видно, кто считал, по какой методике, что пошло не так. Ошибка модели, напротив, выглядит так же уверенно и гладко, как правильный ответ, — и именно это делает её опасной. Модель не краснеет и не мнётся; она выдаёт 145 миллионов с той же безапелляционностью, с какой выдала бы правильные 140.
Поэтому разговор про «ИИ в финансовой отчётности» — это на самом деле разговор про архитектуру. Про то, где проходит граница между вероятностным и детерминированным, что система обязана считать сама, а что можно доверить модели, и как сделать так, чтобы каждая цифра в отчёте имела происхождение, которое можно проверить. Всё остальное — выбор конкретной модели или фреймворка — вторично.
Что именно мы называем галлюцинациями в финансовых данных
Слово «галлюцинация» удобно, но оно склеивает в одну кучу несколько разных вещей. Если мы хотим с чем-то бороться, сначала нужно их разделить. В финансовых данных встречаются как минимум четыре класса ошибок, и у каждого — свой источник и, соответственно, свой контроль.
Первый класс — ошибка извлечения. Модель взяла не ту ячейку, потеряла знак минус, перепутала единицы измерения (тысячи с миллионами) или неверно прочитала структуру таблицы, где итоги стоят не внизу, а сверху. Это самая «механическая» ошибка, и чаще всего она возникает не потому, что модель глупая, а потому, что форматы реальных Excel-файлов устроены хуже, чем примеры из документации: объединённые ячейки, скрытые листы, заголовки в две строки, примечания, которые оказываются важнее чисел.
Второй класс — ошибка интерпретации. Число извлечено верно, но отнесено не туда: не к той статье, не к той компании, не к той валюте или не к тому периоду. Выручка дочернего общества записана как выручка материнской компании, аванс — как выручка, расход будущих периодов — как расход текущего. Классический пример — расходы на предоплаченное программное обеспечение: относить их к текущим расходам периода или капитализировать как нематериальный актив — решение, которое меняет и отчёт о прибылях и убытках, и баланс, а из одной и той же суммы в исходном файле ответ не очевиден. Здесь уже нет проблемы «прочитать», есть проблема «понять, что это значит», — и это как раз та область, где модель действительно полезна и где она же чаще всего ошибается незаметно.
Третий класс — ошибка трансформации. Извлечено и понято правильно, но применено не то правило: не тот курс валюты, не та учётная политика, неверное исключение внутригрупповых оборотов, ошибка в порядке консолидации. Например, внутригрупповая выручка 10 миллионов должна быть исключена из консолидированной, а система её оставила — или исключила дважды.
Четвёртый класс — собственно галлюцинация. Модель создала факт, которого нет: заполнила пропуск в данных догадкой, придумала объяснение расхождению, «вспомнила» цифру из другой компании или периода. Это единственный класс, который честно заслуживает названия галлюцинации, — и он же самый редкий в хорошо спроектированной системе, потому что его проще всего предотвратить: модель просто не должна иметь права порождать числа, у которых нет источника.
Почему нельзя решить всё это одним промптом «не галлюцинируй»? Потому что эти четыре класса возникают в разных местах и по разным причинам. Промпт может снизить частоту четвёртого класса, но он бессилен против перепутанных ячеек в кривом Excel или против неверно применённого курса валюты — это не свойства модели, а свойства данных и правил. Поэтому защита должна быть распределена по всему пути данных, а не сосредоточена в одном месте.
Практический вывод из этой классификации прост: каждый класс ошибок закрывается своим механизмом, и механизмы почти не пересекаются. Ошибку извлечения закрывают программным чтением и проверкой координат. Ошибку интерпретации — каноническими справочниками и ручным подтверждением неоднозначного. Ошибку трансформации — версионированными и протестированными правилами. Галлюцинацию — тем, что у модели нет права порождать числа без источника. Если убрать хотя бы один из этих механизмов, остальные его не заменят: даже идеальное извлечение не спасёт от неверно применённого курса валюты.
Главный архитектурный принцип: AI понимает, расчётный контур считает
Если есть один тезис, вокруг которого строится вся статья, то это он. Систему для финансовой отчётности нужно проектировать как два контура, которые взаимодействуют, но отвечают за принципиально разные вещи.
Вероятностный AI-контур — это всё, где модель приносит пользу своей способностью понимать неструктурированное и неоднозначное: распознавать структуру документов, извлекать и интерпретировать показатели, семантически сопоставлять статьи из разных форматов с каноническими, искать методологические основания в учётной политике, предлагать классификацию, готовить текстовые пояснения. Здесь уместны вероятности, эвристики, «похоже на», «скорее всего».
Детерминированный финансовый контур — это всё, что должно быть воспроизводимо и проверяемо: хранение подтверждённых фактов, справочники, утверждённые правила, арифметика, трансформации, консолидация, контрольные соотношения, версии, аудит и формирование официальных числовых показателей. Здесь нет места вероятностям — детерминированный контур обеспечивает воспроизводимость и проверяемость вычислений, но достоверность результата достигается за счет утвержденных правил, тестов, сверок и контроля исходных данных.доводит неопределенность до нуля
Ключевое правило, которое связывает два контура: AI может инициировать операции через инструменты и предлагать правила, но не может произвольно подменять результат расчётного движка собственным текстом. Модель может сказать «похоже, это статья «Выручка»», но она не имеет права написать в отчёте «выручка = 145 миллионов», если расчётный движок зарегистрировал 140. Она может предложить новое правило консолидации, но применить его может только через утверждённый процесс.
Это продолжение принципа AI-бухгалтера, который мы формулировали раньше: модель понимает смысл первичного документа, но не подменяет детерминированную учётную систему. AI определяет, что 100 — это количество товара, 3291 рубль — цена, а 329100 рублей — сумма без НДС. А вот арифметику, правила учёта, проведение операций и формирование регистров выполняет программная часть. Тот же принцип, перенесённый с первички на отчётность: модель понимает смысл показателя, а расчётный контур делает так, чтобы этот смысл превратился в число, за которое кто-то несёт ответственность.
Важно не скатываться в крайность «LLM вообще нельзя доверять цифры». Модель вполне может рассуждать о числах, проверять арифметику на черновике, предлагать расчёты. Черновые рассуждения модели и финансовые результаты — это разные вещи, и проблема возникает только тогда, когда их перестают различать. Модель может прикинуть «100 плюс 50 минус 10 будет 140» — это полезная проверка. Но зарегистрированным результатом должно стать то, что посчитал расчётный движок, а не то, что модель написала в своём рассуждении.
Тут часто возникает возражение: но ведь детерминированный контур — это тоже просто программа, и в ней тоже бывают баги. Верно, и именно поэтому противопоставление «вероятностное против детерминированного» — это не «умное против глупого» и не «ненадёжное против надёжного». Разница в том, как ошибки себя ведут. Ошибку в детерминированном коде можно воспроизвести, локализовать, покрыть тестом и исправить: она детерминирована, поэтому однажды найденная — больше не повторяется в неизменном виде. Ошибка вероятностной модели невоспроизводима: тот же вход может дать разный выход, и исправить её промптом или патчем часто невозможно. Поэтому надёжность строится не на том, чтобы устранить все ошибки модели, а на том, чтобы модель не могла вносить невоспроизводимые ошибки туда, где числа должны быть бесспорными.
Как должна выглядеть система целиком?
Соберём картинку целиком. Система обработки финансовой отчётности — это не «чат с моделью», а конвейер из восьми слоёв, по которому данные движутся от исходного документа до готового отчёта. Граница между вероятностным и детерминированным контурами проходит не сбоку, а прямо сквозь этот конвейер — примерно после слоя интерпретации.
Слой 1 — источники. ERP, 1С, Excel-файлы, сканы первичных документов, чеки электронной кассы, банковские выписки, отчётные пакеты дочерних обществ, учётные политики и методологии. Всё это — сырьё, и важно, чтобы оно сохранялось в исходном виде: оригинал документа понадобится потом, чтобы доказать, откуда взялась цифра.
Слой 2 — Ingestion и парсинг. Программное чтение структурированных данных там, где это возможно, извлечение текста и таблиц из документов, сохранение оригиналов и их версий. Здесь пока нет никакого «понимания» — только надёжное извлечение сырого содержимого с привязкой к координатам.
Слой 3 — AI Extraction и Interpretation. Собственно работа модели: определить смысл показателей, предложить соответствие канонической модели данных — какая это статья, какая компания, какой период, какая валюта. Всё, что модель здесь говорит, — это предложение, а не факт.
Слой 4 — Validation и Approval. Типизация значений, проверка источников, обязательных полей и неоднозначностей; подтверждение сложных решений, при необходимости — человеком. Это первый шлюз, на котором предложение модели либо превращается в подтверждённый факт, либо отклоняется.
Слой 5 — Canonical Financial Data Model. Подтверждённые факты в канонической форме: юридическое лицо, период, валюта, масштаб, статья, происхождение. Отсюда и далее данные — уже не «что сказала модель», а «что система считает фактом и умеет доказать».
Слой 6 — Rules и Calculation Engine. Утверждённые формулы, трансформации, валютная конверсия, элиминации внутригрупповых оборотов, консолидация. Всё детерминированно: на входе — подтверждённые факты, на выходе — расчётные показатели с идентификаторами и формулами.
Слой 7 — Control и Reconciliation. Контрольные соотношения, полнота, сверки, выявление отклонений. Независимая линия защиты, которая проверяет не то, что сказала модель, а то, что получилось в результате расчётов.
Слой 8 — Reporting и AI Explanation. Формирование таблиц из расчётных данных и генерация пояснений — но только на основании подтверждённых показателей, к которым у модели есть доступ на чтение.
Вот как выглядит граница контуров на схеме:
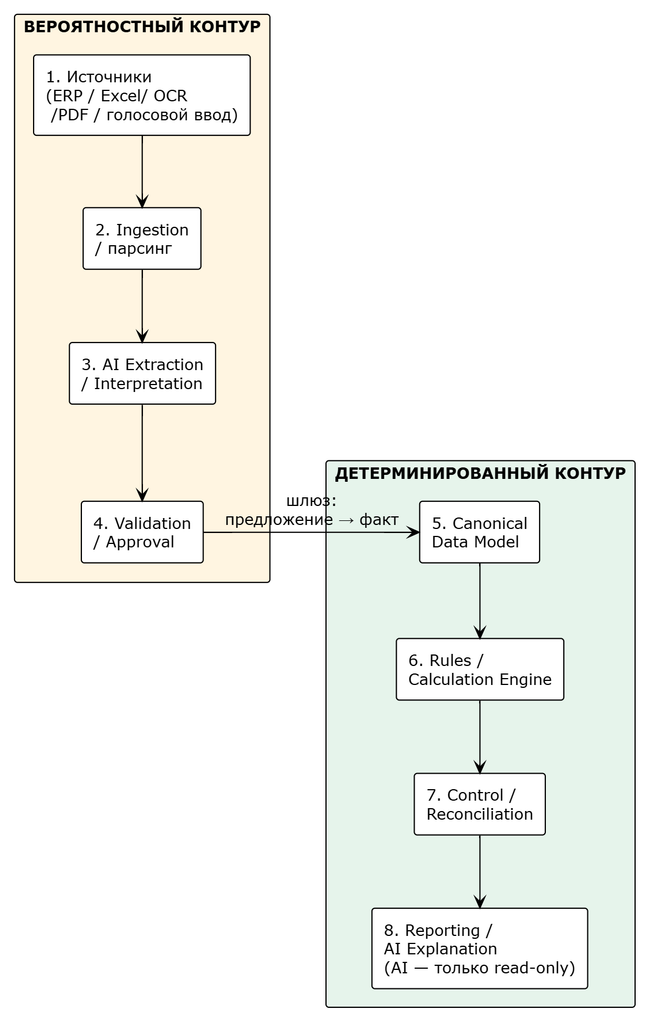
Главное в этой схеме — не конкретные названия слоёв, а направление потока: модель работает с сырыми и неоднозначными данными в начале пути, а числа, которые попадают в отчёт, рождаются только в детерминированной части, после шлюза подтверждения.
Вернёмся к нашей группе «Альфа» — «Бета» — «Гамма». Пакет «Беты» — это Excel с тремя листами и объединёнными ячейками, пакет «Гаммы» — PDF-скан, пакет «Альфы» — выгрузка из учётной системы. На слое ingestion все три превращаются в сырое содержимое с координатами. На слое extraction модель предлагает: вот это — выручка, это — себестоимость, это — внутригрупповая выручка. На слое validation сомнительные сопоставления — вроде той самой классификации расходов на предоплаченное ПО — уходят человеку, остальное подтверждается автоматически. Дальше числа — уже не «предложения модели», а факты с источниками, и расчётный контур складывает их в консолидированную отчётность по утверждённым правилам. Модель возвращается в процесс только на последнем слое, чтобы написать пояснения к уже посчитанным числам.
Каждая цифра должна иметь происхождение
Если систему защиты от выдуманных цифр свести к одному инженерному принципу, это будет data lineage — происхождение каждого числа. Идея проста и радикальна: в системе не может существовать финансового показателя, про который нельзя сказать, откуда он взялся.
Исходный факт — это не «число 100», а структура, в которой есть как минимум: идентификатор, значение, единица измерения, валюта, период, компания, ссылка на документ и на конкретную ячейку или область источника. Выручка компании A — это не просто «100 млн», а «100 млн руб., первый квартал 2026, ООО «Альфа», файл отчет_Альфа.xlsx, лист «ОПУ», ячейка C14». Без ссылки на источник число не считается фактом.
Производный показатель — тоже структура, но ссылается он не на ячейку, а на другие факты и на правило: какие исходные факты участвовали, какая формула, какая версия правила, идентификатор расчёта. Консолидированная выручка — это не «140 млн», а «факт_выручка_А плюс факт_выручка_Б минус факт_внутригрупповая_выручка, формула v3, расчёт #4821».
Вот как это выглядит в явном виде — компактная запись факта и производного показателя (в реальной системе это записи в базе данных, а не текст):
«` Исходный факт: id: 2841 компания: Альфа период: 2026-Q1 валюта: RUB, масштаб: млн статья: Выручка значение: 100 источник: Альфа.xlsx / лист «ОПУ» / ячейка C14
Производный показатель: id: calc-4821 статья: Консолидированная выручка значение: 140 формула: 2841 + 2917 — 3102 версия правила: v3 входные факты: [2841, 2917, 3102] «`
Обратите внимание: формула «сложить выручку и вычесть внутригрупповую» — это не строка текста, которую модель пересказывает, а ссылка на конкретную версию утверждённого правила. Если завтра правило консолидации изменится, изменится ссылка на версию правила, а не просто число в отчёте.
Разберём на сквозном примере. У нас группа из трёх компаний: материнская «Альфа» и две дочерние — «Бета» и «Гамма». Каждая присылает отчётный пакет в своём формате. После обработки в канонической модели лежат факты:
- Выручка «Альфы»: 100 млн (источник: Альфа.xlsx, лист ОПУ, ячейка C14)
- Выручка «Беты»: 50 млн (источник: Бета.xlsx, лист 3, ячейка D8)
- Внутригрупповая выручка — «Альфа» продала «Бете»: 10 млн (источник: акт сверки оборотов)
Расчётный движок считает: 100 плюс 50 минус 10 равно 140. Консолидированная выручка — 140 млн, со ссылками на три исходных факта и формулу.
Теперь ключевой момент. Если модель в своём пояснении напишет «консолидированная выручка составила 145 млн», система не должна оценивать, насколько 145 правдоподобно, — она должна сравнить это число с зарегистрированным расчётным результатом 140 и отклонить расхождение. Правдоподобность — не критерий. Для проверки числового утверждения модели критерием является совпадение с утвержденным расчетным результатом. Достоверность самого результата обеспечивается отдельными контролями.
Именно поэтому «проверка числа на правдоподобие» — плохая защита. 145 млн не менее правдоподобно, чем 140. Вопрос не в том, похоже ли число на правду, а в том, есть ли у него подтверждённое происхождение.
Защита от галлюцинаций на каждом этапе
Если четыре класса ошибок возникают в разных местах, то и защита должна стоять на каждом этапе конвейера — не как одна большая проверка в конце, а как набор локальных барьеров.
На этапе извлечения. Первое и главное правило — не давать модели читать то, что можно прочитать программно. Excel — структурированный формат, и числа из него нужно доставать библиотекой, а не просить модель «посмотри на ячейку C14 и скажи, что там». Модель привлекают только к тому, что действительно требует понимания, — к семантике, а не к чтению чисел. Исходные значения сохраняются как есть, до любых преобразований; проверяются типы, знаки, масштаб (тысячи или миллионы), координаты; каждая цифра получает обязательную привязку к источнику. Для PDF и сканов, где программного чтения нет, добавляется отдельный контроль качества распознавания — потому что OCR ошибается, и эта ошибка должна быть видимой, а не молча вплывать в отчёт.
На этапе интерпретации. Модель должна работать не в вакууме, а против канонических справочников: допустимых статей, компаний, валют, периодов. Семантическое сопоставление статьи из чужого формата с канонической — это задача классификации с ограниченным набором допустимых ответов, а не свободная генерация. Confidence-оценка модели может служить вспомогательным сигналом — «это сопоставление стоит проверить человеку», — но сама по себе уверенность модели ничего не доказывает: модель может быть одинаково уверена и в верном, и в неверном ответе. Неоднозначные маппинги — как та же классификация расходов на предоплаченное ПО — уходят на ручное подтверждение.
На этапе трансформаций. Правила должны быть формализованы, версионированы и протестированы до того, как их применят к реальным данным. LLM может предлагать новое правило или изменение существующего — это полезно, потому что учётная политика меняется и кто-то должен это замечать, — но применить новое финансовое правило без предусмотренного процесса утверждения модель не имеет права. Изменение правила — это управленческое решение, а не вычисление.
На этапе расчётов. Здесь модель вообще не должна свободно генерировать числа. Арифметика выполняется в точной финансовой нотации — Decimal или её аналогах, а не в двоичной плавающей запятой, которая не умеет точно представлять десятичные дроби и накапливает ошибки округления. Округление контролируется явными правилами, курсы валют берутся из утверждённого справочника, а не «прикидываются» моделью, и любой расчёт можно воспроизвести, прогнав его заново с теми же входами.
На этапе формирования отчёта. Таблицы строятся из зарегистрированных расчётных результатов, а не из текста модели. Модель получает данные только на чтение и генерирует пояснения, но каждый упомянутый ею показатель сверяется с допустимыми фактами и расчётами. Если модель в пояснении ссылается на цифру, которой нет в зарегистрированных результатах, — это повод остановиться и разобраться, а не вписать цифру в отчёт.
Логика одна и та же на всех этапах: модель уменьшает неопределённость там, где данные сырые и неоднозначные, а система переводит неопределенность в явно зафиксированные допущения, подтвержденные решения и контролируемые расчетные процедуры там, где числа становятся официальными.
Отдельно стоит сказать про наивные способы защиты, которые не работают, хотя звучат убедительно. Промпт «не выдумывай числа» не работает, потому что модель не отличает выдумку от воспоминания — она генерирует и то и другое одинаково уверенно. Жёсткий порог по confidence не гарантирует ничего, потому что модель может быть высоко уверена в неверном ответе. А «попросить вторую модель перепроверить первую» не создаёт источника истины: обе модели делят одни и те же ограничения и могут согласиться друг с другом в одной и той же ошибке. Всё это может быть полезным вспомогательным сигналом, но ни один из этих приёмов не создаёт подтверждённого происхождения цифры — а именно оно, а не уверенность модели, делает число достоверным.
Контрольные соотношения и сверки — независимая линия защиты
Проблема в том, что происхождение цифры ещё не гарантирует её правильность. Число может быть корректно извлечено из источника, но источник сам ошибается, или число отнесено не к той статье. Поэтому, помимо происхождения (lineage), нужна вторая, независимая линия защиты — финансовые инварианты и сверки.
Инвариант — это соотношение, которое должно выполняться всегда, независимо от того, как именно собраны данные. Самый простой: баланс должен сходиться — активы равны обязательствам плюс капитал. Итог детализации должен равняться итоговой строке. Внутригрупповые обороты должны быть согласованы: то, что «Альфа» показала как продажу «Бете», «Бета» должна показать как покупку у «Альфы», и в консолидации эти суммы должны взаимно погаситься. Все отчётные пакеты должны быть на месте, валюты и периоды — корректны, обязательные корректировки — применены.
Стоит оговорить, где здесь норма, а где — наш архитектурный принцип. Требование исключать внутригрупповые остатки, операции и нереализованные прибыли — это не наша выдумка, а прямое требование стандарта консолидации: в МСФО это IFRS 10 (пункт B86), в US GAAP — ASC 810. А вот как именно устроить контроль исполнения этого требования внутри ИТ-системы — это уже инженерное решение, и наша двухконтурная схема — один из способов его реализовать, а не единственный.
Эти проверки не зависят от модели. Они написаны как детерминированные правила и выполняются над расчётными результатами. Их ценность именно в независимости: даже если модель ошиблась в интерпретации, сверка с другим источником или с инвариантом это обнаружит.
Отдельная история — аномалии и сравнение с прошлым периодом. Если выручка компании «Бета» выросла вчетверо за квартал, это не значит, что в данных ошибка, — но это значит, что на это место стоит посмотреть. Отклонение от прошлого периода не доказывает ошибку, оно лишь направляет проверку. И здесь у модели есть честная и полезная роль: она может объяснять обнаруженные аномалии и предлагать гипотезы — «рост выручки может объясняться крупным контрактом из отчёта о движении денежных средств». Но она не должна объявлять неподтверждённую гипотезу установленным фактом. Гипотеза остаётся гипотезой, пока её не подтвердил источник или специалист.
Где здесь RAG и почему он не должен быть базой финансовой истины?
RAG — retrieval-augmented generation — часто предлагают как универсальное решение проблемы галлюцинаций: дайте модели доступ к документам, и она будет отвечать по ним. В финансовой отчётности RAG действительно нужен, но его роль скромнее, чем обычно думают: это механизм поиска методологических оснований, а не хранилище финансовых фактов.
Модели нужно где-то искать ответы на вопросы «как это интерпретировать»: что говорит учётная политика о классификации этих расходов, какое правило консолидации действует для этой пары компаний, какой справочник использовать, что было решено по похожему случаю раньше. Всё это — методология, и RAG хорошо подходит для её поиска.
При этом в зрелой системе сочетаются разные способы поиска, потому что ни один по отдельности не достаточен. Лексический поиск — по точным кодам, названиям и терминам: если в справочнике есть статья с кодом 2110, её нужно находить по коду, а не «по смыслу». Смысловой векторный поиск — по описаниям и методологиям: «как мы классифицируем расходы на предоплаченное ПО». Структурированные запросы — к финансовой базе, где лежат факты: их не ищут семантически, их читают по идентификаторам. Поверх — фильтрация по версии документа, компании, периоду и статусу, и reranking, который проверяет, что найденное основание действительно релевантно, а не просто похоже.
Ключевая мысль: RAG помогает модели найти, как следует интерпретировать или обработать данные, но сами финансовые факты должны находиться в структурированном и контролируемом хранилище. Если модель отвечает на вопрос «какая у нас выручка за квартал», она должна читать ответ из базы фактов, а не «вспоминать» его из найденных документов.
И ещё одно, о чём легко забыть: наличие ссылки на документ само по себе не гарантирует правильность интерпретации. Модель может найти верный пункт учётной политики и неверно его применить, найти устаревшую версию документа или «прочитать» в нём то, чего там нет. RAG снижает частоту выдумок, но не устраняет их полностью — и уж точно не заменяет детерминированный расчётный контур.
Конкретный пример. Модель ищет в учётной политике правило о классификации расходов на предоплаченное ПО и находит верный пункт. Но применяет его неверно: пункт говорит «капитализировать, если срок полезного использования превышает год», а модель решает, что лицензия на полгода тоже подлежит капитализации. Источник найден правильно, интерпретация — нет. Ссылка на документ в этом случае честная, а решение ошибочное. Именно поэтому проверка того, что модель нашла, и проверка того, что она решила, — это две разные проверки.
Human-in-the-loop без превращения процесса в ручной ад
Если на каждую неоднозначность звать человека, автоматизация превратится в худшую версию ручной работы — с той разницей, что теперь человек ещё и должен проверять модель. Поэтому участие человека нужно проектировать так же осознанно, как и остальную архитектуру.
Специалисту должны попадать только решения, которые реально требуют его компетенции: неоднозначная классификация, новое или изменённое правило, существенное расхождение, отсутствие источника, нетипичная корректировка. Всё типовое — извлечение, проверенные маппинги, стандартные трансформации, обычные сверки — должно проходить автоматически. Цель не в том, чтобы человек проверил каждую цифру, а в том, чтобы автоматизировать типовые случаи и направить внимание человека именно на исключения.
Практически это выглядит как несколько уровней зрелости. Сначала система работает в режиме «AI предлагает, человек подтверждает»: модель делает сопоставления и расчёты, но человек утверждает каждый результат. По мере накопления подтверждённых паттернов часть решений переводится в правила, которые исполняются автоматически: если статья в пакете называется ровно так и формат совпадает с проверенным, зачем спрашивать в десятый раз. Новые или рискованные случаи — непривычный формат, расхождение, нестандартная корректировка — продолжают проходить через контроль человека.
Важно, что это не «человек в конце, на подстраховке», а человек, встроенный в процесс именно там, где его решение что-то меняет. Каждое его подтверждение или отклонение — не разовая правка, а сигнал: подтверждённый маппинг может стать правилом, отклонённое предложение — уроком для следующих запусков. Так система не просто перекладывает на человека рутину, а постепенно учится на его решениях.
Вернёмся к классификации расходов на ПО. Первые несколько раз система видит этот случай впервые и отправляет его финансисту с вариантами: «похоже на текущие расходы, уверенность 0.6; похоже на нематериальный актив, уверенность 0.4». Финансист выбирает «нематериальный актив». Система запоминает решение и в следующий раз, встретив тот же признак — та же статья в пакете, тот же срок лицензии, — применяет правило автоматически, не спрашивая. Но если через квартал придёт пакет с новой формулировкой, система снова остановится и спросит. Человек не проверяет каждую цифру — он размечает редкие и новые случаи, и его решения постепенно превращаются в автоматические правила.
Агентский интерфейс: можно ли попросить «собери ОПУ за квартал»
Когда вся архитектура на месте, естественно хочется поверх неё удобный интерфейс — и тут появляются агенты. Сценарий выглядит соблазнительно: аналитик пишет «собери ОПУ за квартал», и агент сам делает всё остальное.
Такой сценарий возможен — при одном условии. Агент — это не отдельный «умный сотрудник» с собственными полномочиями, а тонкий оркестратор поверх описанных выше контуров. Он получает задачу, строит план, вызывает инструменты, проверяет комплектность данных, запускает утверждённые трансформации, получает результат, выполняет сверки и формирует пояснения. Но он не имеет полномочий самостоятельно создавать подтверждённые финансовые факты или менять методологию — ровно по тем же правилам, что и любая другая часть системы.
Ключевое — разделение прав. Чтение данных — одна операция. Предложение изменений — другая. Запуск расчётов — третья. Подтверждение корректировок — четвёртая, и она часто остаётся за человеком. Публикация отчётности — пятая, и она не должна быть доступна агенту по умолчанию. Агент может пройти весь путь до финального черновика отчёта, но момент «отправить» — это решение человека, с явным подтверждением.
К этому добавляются две вещи, без которых агент в финансах опасен: аудит действий и версионирование результатов. Каждое действие агента — какой инструмент он вызвал, с какими аргументами, какой результат получил — должно логироваться и быть воспроизводимым. Каждый расчёт и каждый отчёт — версионироваться. Тогда на вопрос «почему в отчёте эта цифра» всегда есть ответ, который можно пройти по шагам.
Агент — это не способ обойти контроль, а способ сделать его менее заметным для пользователя. Человек просит «собери ОПУ», а система под капотом прогоняет данные через все те же шлюзы и сверки. Удобство — на уровне интерфейса, жёсткость — на уровне данных.
Как доказать заказчику, что система надёжна
Остаётся практический вопрос: как убедить скептичного заказчика, что всё это работает, а не просто красиво описано. Ответ — не обещать, а показать на ограниченном пилоте с измеримым результатом.
Начать стоит с одного узкого процесса — например, консолидации ОПУ нескольких компаний. Не «всю финансовую функцию», а один воспроизводимый сценарий, у которого есть понятный вход и понятный результат.
Дальше — зафиксировать эталон. Специалисты готовят отчётные пакеты и правильные результаты вручную, и этот результат становится золотым стандартом, с которым сравнивают систему. Без эталона невозможно измерить качество: непонятно, с чем сравнивать.
Затем — собрать набор сложных случаев, а не только удобные примеры. Разные форматы Excel, неоднозначные статьи, отсутствующие данные, отрицательные суммы, разные валюты, внутригрупповые обороты. Пилот ценен ровно настолько, насколько его тестовый набор напоминает реальную грязь реальных данных.
И — измерять правильные вещи. Качество извлечения: сколько цифр прочитано верно. Точность сопоставлений: сколько статей отнесено к правильным каноническим. Доля автоматической обработки: сколько прошло без вмешательства человека. Количество ошибок, пойманных контролями, и — отдельно и особенно — количество ошибок, дошедших до финального отчёта. Последняя метрика важнее всех остальных: система может ошибаться сколько угодно внутри, если ни одна ошибка не доходит до результата. Отдельно измеряются время подготовки отчётности и объём ручной работы — это то, ради чего всё затевалось.
И одно методологическое замечание, о которое спотыкаются многие: не смешивайте качество LLM с качеством всего процесса. Модель может ошибаться в сопоставлениях, но если контрольные соотношения ловят эти ошибки до отчёта, система в целом надёжна. Обещание «100% точности модели» некорректно в принципе — модель по своей природе вероятностна. А вот обещание «контролируемый уровень риска, воспроизводимость, обнаружение ошибок и невозможность неконтролируемого включения неподтверждённых данных в отчёт» — это то, что можно реально выполнить и измерить.
И последнее: пилот имеет смысл запускать не для того, чтобы «посмотреть, получится ли», а чтобы получить числа, по которым можно принять решение о масштабировании. Если в пилоте на ограниченном процессе ошибки доходят до финального отчёта — это не «модель плохая», а повод добавить контроль на том этапе, где ошибка проскочила. Каждая такая ошибка — не провал, а конкретное место, где система ещё не достроена. Надёжность здесь не свойство, которое покупают вместе с моделью, а результат итераций, каждая из которых делает проход более контролируемым, чем предыдущий.
Заключение
Вернёмся к вопросу, с которого всё началось: «А если LLM выдумает цифру?»
Правильный ответ — не «не выдумает, она хорошая» и не «значит, никакого ИИ». Правильный ответ: система должна быть устроена так, чтобы цифра без подтверждённого источника или расчёта не могла стать финансовым фактом. Не потому, что модель никогда не ошибётся, а потому, что её ошибке негде будет просочиться в отчёт.
Вероятностный контур делает то, что умеет лучше всего: понимает смысл неструктурированных данных, сопоставляет, предлагает, объясняет. Детерминированный контур делает то, что должно быть бесспорным: считает, хранит, проверяет, версионирует. Граница между ними — не техническая деталь, а вопрос ответственности: кто отвечает за число, стоящее в отчёте.
Зрелая AI-интеграция в финансах — это не замена финансовой системы чат-ботом. Это создание управляемого процесса, в котором AI расширяет возможности человека и существующей ИТ-инфраструктуры, а не подменяет их. Ценность возникает не от того, что к учёту подключили модель, а от того, что процесс перестроили так, чтобы его результат был измеримым, воспроизводимым и контролируемым. И в этом смысле финансы — не исключение, а самый честный полигон для той архитектуры, о которой мы говорим в этой серии: не «AI всё сделает», а «AI меняет процесс, а за результат по-прежнему отвечает человек».