Экономика ИИ-контроля: ожидаемые потери, остаточный риск и риск-ориентированное участие человека
Ловушка идеального результата
Почти каждое обсуждение внедрения ИИ в контроль качества проходит по одному сценарию. Сначала — убедительная демонстрация: система находит несоответствия в документации, сверяет расчёты, сопоставляет данные со справочниками, подсвечивает подозрительные места. Выглядит полезно. А потом звучит вопрос, который останавливает разговор:
«Хорошо, а если она пропустит пять процентов ошибок? Нам ведь всё равно придётся всё перепроверять вручную. Тогда зачем она вообще нужна?»
Формулировка настолько привычна, что её редко разбирают на части. А зря: внутри неё происходит незаметная подмена. Новую систему сравнивают не с реальным процессом, который есть в компании сегодня, а с воображаемым идеальным контролем, который якобы не пропускает ничего. Между тем реальный процесс — ручная проверка документов опытными специалистами — никогда не был стопроцентным. У него свои пределы: усталость в конце рабочего дня, нехватка времени перед сдачей проекта, неоднозначность исходных данных, ошибки в применении нормативов, когда два специалиста читают один и тот же пункт по-разному.
То есть вопрос «что, если система пропустит 5%» неявно предполагает, что без системы пропускается 0%. Это и есть ловушка идеального результата: мы требуем от нового инструмента того, чего никогда не было у старого процесса, — и на этом основании отказываемся от него, хотя он, возможно, был бы заметно лучше того, что есть.
Стоит понять, откуда вообще берётся это требование. Оно редко бывает продуманным техническим условием. Чаще это эмоциональная реакция на неопределённость: руководитель чувствует, что передаёт контроль чему-то, что не до конца понимает, и пытается вернуть ощущение управляемости, потребовав гарантии, которой не даёт ни один инструмент — включая, если честно, и его собственных сотрудников. Требование «100%» в этом смысле не спецификация, а способ снять тревогу. Поэтому спорить с цифрой бесполезно: нужно переводить разговор из плоскости «дайте гарантию» в плоскость «давайте измерим риск и договоримся, кто за что отвечает».
Отсюда — правильная постановка вопроса. Не «гарантирует ли система, что ошибок не будет», а: что именно должно измениться после внедрения — количество ошибок, величина потерь, трудозатраты, сроки проверки или всё это вместе? И как измерить это изменение, сравнив его не с идеалом, а с текущим положением дел?
Есть и ещё одна незаметная сторона вопроса. Ручной контроль — это не бесплатный идеал, с которым сравнивают систему, а дорогой процесс со своей ценой и своими поломками. Высококвалифицированные сметчики и проектировщики тратят значительную часть времени не на то, где их суждение незаменимо, а на рутинную сверку позиций, пересчёт объёмов, поиск актуальной версии норматива. Каждый час, потраченный на это, — час, не потраченный на содержательную инженерную работу. Поэтому корректное сравнение — не «система против идеального нуля ошибок», а «нынешний процесс с его ценой и его процентом ошибок против процесса, дополненного системой». И сравнивать нужно по всем осям сразу: потери, трудозатраты, сроки, качество.
Сквозной пример: проектно-сметная документация
Чтобы разговор не оставался абстрактным, возьмём конкретную область — проектирование объектов капитального строительства: инженерные сети, магистральные коммуникации, производственные сооружения, здания. Проверка проектно-сметной документации — хороший полигон, потому что здесь ошибки стоят денег и почти всегда всплывают не сразу.
Документ живёт долго и проходит несколько рук. Сначала проектировщик готовит проектную документацию и ведомости объёмов работ. Потом сметчик переводит эти объёмы в деньги, выбирая нормативы и расценки из справочников. Дальше документ проверяют, согласуют, утверждают — и только после этого он превращается в бюджет и план закупок. На каждом переходе информация передаётся из одних рук в другие, и на каждом переходе возможна потеря: объём из чертежа не попал в ведомость, ведомость прочитали не так, норматив применили в устаревшей версии. К тому моменту, когда ошибка проявляется, её источник часто уже на несколько шагов назад по цепочке.
Предметно это устроено так. Сметчики и проектировщики работают с нормативными справочниками, ресурсными нормами, текущими ценами, коэффициентами, спецификациями и ведомостями объёмов работ. Каждая позиция сметы — это не просто «сколько стоит», а цепочка: норматив расхода ресурса на единицу работы, единичная расценка, объём работ, поправочный коэффициент, версия нормативной базы. Ошибка может спрятаться в любом звене.
Типичный случай: норматив задаёт расход материалов на один километр коммуникации, цена в справочнике указана за одну тысячу единиц, а фактическая потребность по проекту — пятьдесят единиц. Чтобы посчитать стоимость корректно, нужно правильно привести единицы измерения, применить нужные объёмы, коэффициенты и именно ту версию норматива, которая действует сейчас, а не ту, что была в прошлом квартале. Ошибка в любом из этих шагов даёт неверную сумму.
Отдельная головная боль — версии нормативов и справочников. Нормативная база обновляется, расценки пересматриваются, выходят новые редакции методик, и то, что было верным в прошлом квартале, в этом уже ошибка. Человек физически не может держать в голове все версии и даты их ввода; система может — если у неё есть актуальный справочник и формальное правило, по которому проверяется применимость версии. Это один из тех случаев, где автоматизация выигрывает у человека не «умом», а объёмом и дисциплиной: она не устаёт и не полагается на память.
Последствия асимметричны. Завышенная стоимость — это переплата и завышенный бюджет. Заниженная — недостаточное финансирование, которое обнаруживается уже на этапе строительно-монтажных работ, когда деньги распределены, закупки запланированы, а пересогласование бюджета стоит дороже самого исправления. Часть дефектов в принципе видна только на стройке: в документации они неразличимы, пока материалы не начали приходить, а работы — выполняться.
Перечислим, с чем система имеет дело на практике, — это поможет понять, почему «найти 95%» и «найти нужные 95%» не одно и то же. Одни дефекты локальны и дёшевы: опечатка в наименовании материала, пропущенная строка в ведомости, которую легко дозаполнить на этапе проверки. Другие системны и дороги: неверный коэффициент, применённый к целому разделу сметы, устаревшая расценка, использованная в десятках позиций, несовпадение объёмов между чертежом и спецификацией. Третьи редки, но разрушительны: неправильно понятая версия норматива, из-за которой весь расчёт раздела построен на неверной базе. Общий процент обнаружения смешивает эти классы в одну кучу, а экономика — нет.
Интеллектуальная система в этом процессе может многое: сверять спецификации с нормативами, находить пропущенные ресурсы, неверные пересчёты единиц, устаревшие расценки, несовпадения объёмов между ведомостью и чертежами. Но важно сразу сказать, что её задача — не магически гарантировать абсолютную правильность каждого документа. Её задача — сделать процесс проверки заметно дешевле и надёжнее, чем он был. И вот здесь начинается самое интересное: как оценить, получилось ли это.
Экономическая логика вместо абстрактных процентов
Первое, что нужно разделить, — это две разные вещи: метрику обнаружения ошибок и экономический эффект. «Система находит 95% ошибок» — это про обнаружение. «Система окупается» — это про деньги. Между ними нет прямой связи, и это главная причина, по которой разговор про проценты так часто заводит в тупик.
Возьмём простой условный пример. Пусть текущий процесс за год пропускает сто ошибок, и каждая в среднем обходится компании в некоторую сумму. Дополнительная система находит девяносто пять из них, пять остаются. Если предотвращённые потери по девяноста пяти ошибкам существенно превышают стоимость самой системы, внедрение экономически оправдано — несмотря на то, что пять ошибок всё равно проскочили. Ключевое слово здесь «условный»: это иллюстрация логики, а не результат какого-то реального проекта, и воспринимать эти цифры нужно именно так.
Но реальность сложнее, и вот почему. Ошибки не одинаковы. Система может находить 95% всех дефектов — и при этом пропускать именно те, что стоят дороже всего. Если она безупречно ловит мелкие опечатки в спецификациях, но пропускает неверно применённый коэффициент, из-за которого смета завышена на восемь процентов, общий процент обнаружения будет выглядеть прекрасно, а экономический смысл внедрения окажется близок к нулю. И наоборот: система с более скромным общим recall может предотвращать значительную долю ожидаемого ущерба, если надёжно выявляет именно критичные классы ошибок.
Правильно считать эффект не одним числом на весь поток, а суммой по классам: для каждого класса ошибок — своя частота, своя стоимость, своя вероятность обнаружения. Тогда формула остаётся той же, но R_base и R_new раскладываются на слагаемые, и сразу видно, на каком классе система реально экономит деньги, а на каком — только создаёт иллюзию контроля. Для управленческого решения такой разрез полезнее одного процента: он показывает, куда направить доработку и где оставить обязательного эксперта.
Отсюда — четыре понятия, на которых держится вся дальнейшая логика. Ожидаемый ущерб — это то, во что в среднем обходятся ошибки, умноженные на их вероятность и стоимость. Остаточный риск — то, что остаётся после всех проверок.
Ключевое слово в «ожидаемом ущербе» — «ожидаемый». Речь не о конкретной сумме, которая точно случится, а о математическом ожидании: вероятности ошибки, умноженной на её стоимость. Это важно, потому что многие разговоры о контроле ведутся так, будто риск — это фиксированная цифра, которая либо есть, либо нет. На самом деле риск — это распределение: много мелких вероятных потерь и редкие, но крупные. Система снижает ожидаемый ущерб не потому, что «убирает риск», а потому, что сдвигает это распределение вниз — уменьшает и частоту, и тяжесть. Принимать решение нужно именно об этом сдвиге, а не о несуществующей гарантии. Стоимость контроля — во что обходится сама проверка, автоматическая и ручная. Предотвращённые потери — разница между ущербом, который был бы без системы, и тем, что остался с ней.
Стоит отдельно сказать про C — стоимость самой системы, которую часто занижают или, наоборот, раздувают. В неё входит не только цена лицензий, но и внедрение, интеграция с существующими справочниками, обучение людей, сопровождение и обновление нормативной базы. Это не разовый платёж, а ежегодный. С другой стороны, в той же формуле есть и экономия на самом контроле: если система берёт на себя массовую проверку, часть ручного труда высвобождается, и это тоже деньги. Аккуратная оценка C — половина честного вывода о том, окупается ли внедрение; вторая половина — честная оценка Rnew, которой часто боятся, потому что она признаёт, что риск не исчезает полностью.
В простейшем виде экономический эффект можно записать так:
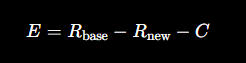
где Rbase — ожидаемые потери в существующем процессе, Rnew — ожидаемые остаточные потери после внедрения, а C — совокупная стоимость системы. Если эффект положительный, внедрение имеет экономический смысл; если отрицательный — не имеет, и никакой красивый процент обнаружения этого не отменит.
Раскроем формулу на условных числах, чтобы она не осталась абстракцией. Допустим, сейчас компания несёт в среднем десять миллионов рублей убытков в год из-за ошибок, дошедших до стройки, — это Rbase. Система с лицензиями, внедрением и сопровождением обходится в два миллиона в год — это C. Если после внедрения остаточные потери падают до трёх миллионов — это _new — эффект составит 10 минус 3 минус 2, то есть 5 миллионов в год. Если же система ловит только мелочь и остаточные потери почти не меняются, скажем, держатся на девяти миллионах, эффект отрицательный: 10 минус 9 минус 2 равно минус один, и никакой «recall 95%» это не спасёт. Все числа условные, но соотношение они показывают честно: эффект — это не процент, а разница между тем, что было, и тем, что стало, за вычетом цены инструмента.
И ещё одна тонкость, которую легко упустить. Нельзя механически перемножать вероятности обнаружения человеком и ИИ, предполагая, что они независимы, и на этом основании обещать «совместный» сверхвысокий результат. Если человек и система используют один и тот же устаревший норматив или одинаково интерпретируют неоднозначный документ, их ошибки коррелированы: они будут ошибаться в одних и тех же местах, а не «прикрывать» друг друга. Реальная надёжность комбинации ниже, чем подсказывает наивный расчёт.
Иными словами, добавление ИИ не превращает контроль в два независимых фильтра, вероятности которых перемножаются. Это один процесс с общими источниками ошибок — теми же нормативами, теми же данными, теми же неоднозначностями. Польза от второго фильтра есть, но она в том, что он устроен иначе и ошибается в других местах, а не в том, что его ошибка механически перемножается с ошибкой человека. Чтобы получить выигрыш, нужно, чтобы человек и система ошибались по-разному, а не одинаково.
Возражение о двойных расходах
Теперь — самое частое возражение: «Если человек всё равно проверяет документ, мы просто добавили стоимость ИИ к прежним расходам».
Начнём с честного признания. Если процесс не менять — то есть ИИ проверяет всё, а человек затем в прежнем объёме повторяет всю ту же работу, — трудозатраты действительно могут вырасти. Это правда, и закрывать на неё глаза не нужно. Но из неё не следует, что система бесполезна: даже в таком, самом консервативном варианте она всё ещё может окупаться за счёт предотвращённых потерь, если ловит дорогие ошибки.
Однако настоящий вопрос в другом: зачем вообще оставлять процесс неизменным? Разумный подход — изменить саму организацию контроля. Интеллектуальная система выполняет массовые проверки, формирует замечания, выделяет неопределённые случаи и классифицирует позиции по риску. Эксперты после этого сосредотачиваются не на перепроверке всего подряд, а на исключениях, критичных позициях, неоднозначных нормативах и выборочном аудите. Человек перестаёт делать ту работу, которую надёжнее и дешевле делает система, и занимается тем, где его суждение действительно незаменимо.
Схематически целевой процесс выглядит так:
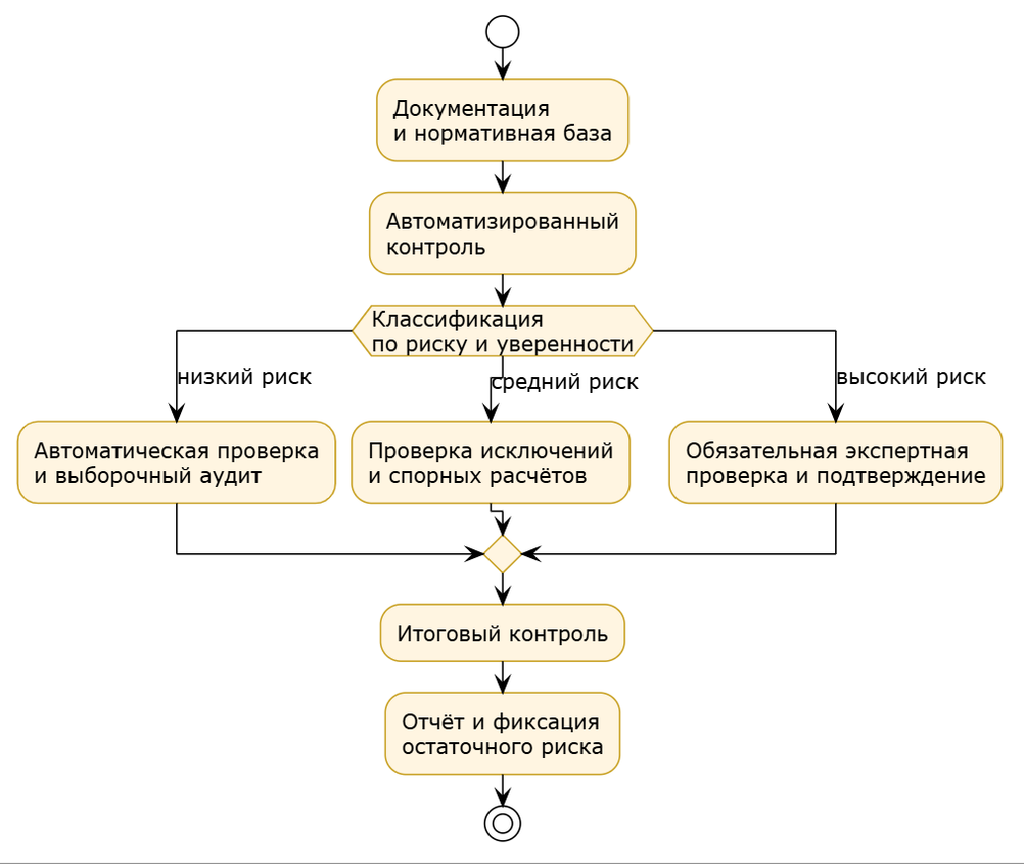
Три маршрута на схеме не для красоты. Низкорисковые позиции — типовые расчёты, стандартные материалы, проверенные связки — система обрабатывает автоматически, а человек касается их только выборочным аудитом. Средний риск — позиции с расхождениями, спорными расчётами, редкими коэффициентами — уходит на проверку исключений. Высокий риск — критичные конструкции, крупные суммы, неоднозначные нормативы — всегда проходит через эксперта с явным подтверждением. Внимание человека, которое раньше размазывалось по всему документу тонким слоем, теперь концентрируется там, где ошибка действительно дорога.
Важно не перегнуть в другую сторону. Мы не утверждаем, что человек обязательно должен быть исключён из процесса. Для некоторых документов и классов рисков полная экспертная проверка может оставаться обязательной — по нормативным причинам или по тяжести последствий ошибки. Экономия трудозатрат — возможный, но не единственный источник ценности системы. Ценность может быть и в скорости, и в однородности проверки, и в накопленной доказательной базе, по которой потом можно разбирать каждое решение.
Переход к такой организации не происходит в один день, и это нормально. Практически он выглядит как несколько уровней. Сначала система работает в режиме «находит и предлагает», а человек по-прежнему проверяет всё — это дорого, но даёт организации время накопить доверие к инструменту и понять, где он надёжен, а где нет. Потом подтверждённые типовые проверки переводятся в автоматические, и человек касается только исключений. И только затем, по мере накопления статистики, риск-ориентированная маршрутизация становится основным режимом работы. На каждом шаге измеряется одно и то же — ошибки, потери, трудозатраты, — чтобы переход опирался на числа, а не на энтузиазм.
Почему LLM не должна быть единственным механизмом проверки?
Здесь стоит снять одно распространённое недопонимание. Когда говорят «ИИ проверяет смету», легко вообразить языковую модель, которая читает документ и единолично решает, верны ли все цифры. Это была бы плохая система — и именно поэтому хорошая так не устроена.
Правильная архитектура разделяет ответственность между несколькими компонентами. Лексический и семантический поиск находят релевантные нормативы, справочники и фрагменты документации. LLM извлекает смысл, сопоставляет позиции, определяет применимые нормы и структурирует данные — то есть делает то, в чём она действительно сильна: понимание неструктурированного. Детерминированные модули выполняют арифметику, пересчёт единиц, применение коэффициентов и проверку формул — то, что должно быть воспроизводимым и бесспорным. Движок правил контролирует версии нормативов, допустимость их применения и обязательные ограничения. А отдельное хранилище сохраняет происхождение каждого значения и доказательства — чтобы потом можно было аудировать любое решение.
Конкретный пример. LLM может определить, что в позиции расход задан на один километр, а цена в справочнике указана за тысячу единиц. Но сам расчёт потребности и итоговой стоимости должен выполнять проверяемый программный модуль, а не модель. Модель говорит «здесь норматив применяется к километру, а цена — к тысяче единиц», и на этом её роль заканчивается; пересчёт делает детерминированный код, который можно прогнать ещё раз и получить тот же результат.
Вернёмся к примеру с единицами измерения, потому что он хорошо показывает границу ответственности. Модель читает позицию сметы и видит: расход «0,35» — и это, судя по контексту, расход на один километр. А в справочнике расценка «12 400» — и это, судя по заголовку раздела, цена за тысячу единиц. Понять это — работа понимания, и модель с ней справляется. А вот посчитать, что при потребности в пятьдесят единиц итоговая стоимость составит такую-то сумму, — это уже работа арифметики, и её выполняет модуль, который переводит единицы по формальному правилу и который можно прогнать ещё раз. Если ошибся модуль, это воспроизводимый баг, который чинится тестом; если ошиблась модель, это невоспроизводимая догадка, которую не зафиксировать. Поэтому их и разделяют.
Архитектурно это выглядит так:
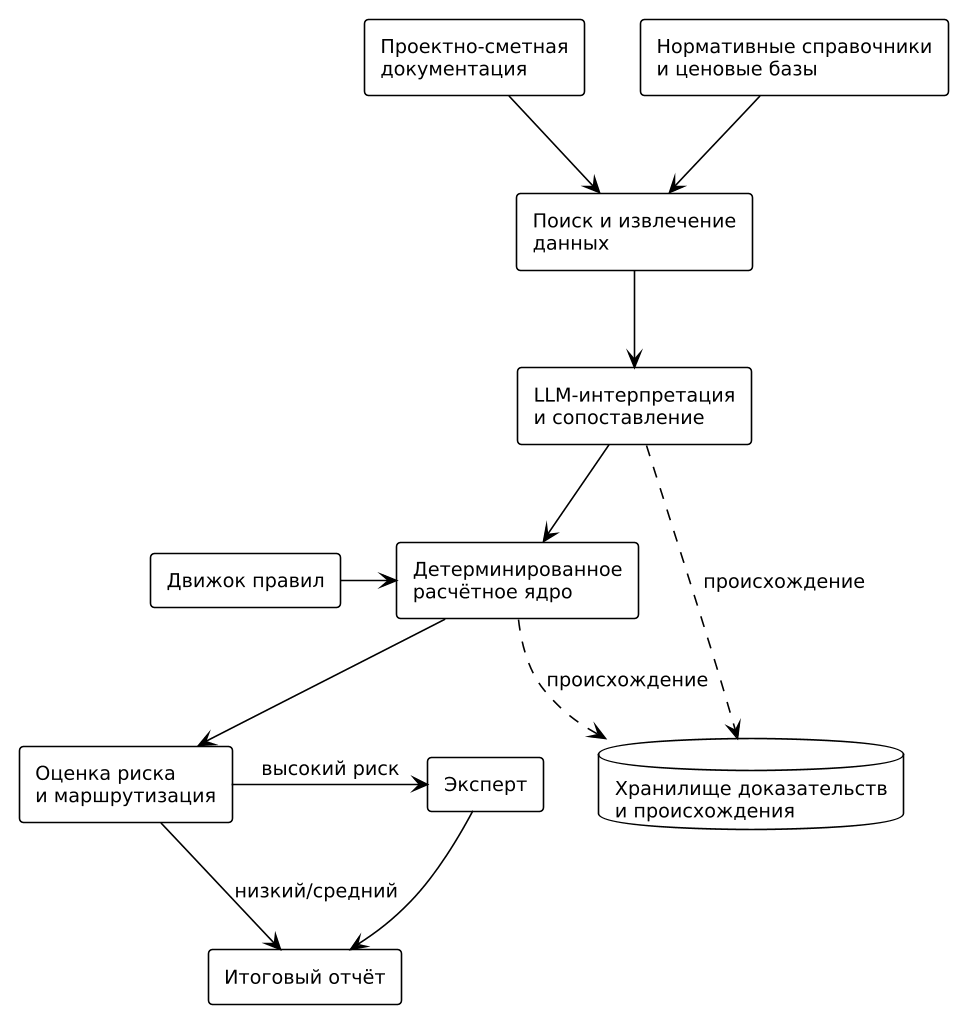
Зачем такое разделение? Оно уменьшает пространство ошибок. Генеративная модель хорошо справляется с неоднозначностью и плохо — с арифметикой, которую к тому же не может воспроизвести одинаково два раза подряд. Детерминированный модуль — наоборот. Поручив каждому то, в чём он надёжен, мы получаем систему, которая в сумме надёжнее, чем попытка возложить всю работу на одну модель — или, наоборот, написать всё жёсткими правилами, которые сломаются о первый же нетипичный документ.
Отдельного внимания заслуживает хранилище доказательств и происхождения данных. Когда система заявляет «в этой позиции применён устаревший норматив», она должна показать, откуда это следует: какой пункт какого справочника, какая версия, какое значение стояло в документе. Без этого замечание невозможно ни проверить, ни оспорить, а значит, оно не создаёт доверия, сколько бы процентов обнаружения ни показывали на презентации. Доказательная база превращает каждое срабатывание из «модель так считает» в «вот источник, вот расхождение, вот вывод» — и именно она делает контроль аудируемым, а не магическим.
Как доказать эффект до промышленного внедрения?
Теоретически всё складно, но руководителю нужно решение, а не рассуждение. Как показать эффект, не разворачивая систему в промышленную эксплуатацию? Ответ — ограниченный эксперимент с честными метриками.
Первое — репрезентативный набор документов с уже известными ошибками. Причём набор должен включать не только типовые дефекты, но и редкие и критичные: именно они определяют большую часть ожидаемого ущерба, и именно на них проверяется, умеет ли система отличать важное от неважного.
Откуда взять «известные ошибки» для такого набора? Из реальной истории: прошлые проекты, по которым уже есть найденные на стройке или при аудите дефекты, ретроспективно размечаются и становятся эталоном. Можно дополнительно вносить специально сконструированные ошибки в типовые документы — так получаются редкие и критичные случаи, которых в свежей истории мало. Важно, чтобы эталон готовили люди, которые знают предмет, а не те, кто внедряет систему, — иначе оценка превратится в самообслуживание. Хороший эталон — это половина доверия к результатам пилота. Второе — сравнить два процесса: текущий ручной и тот же процесс, дополненный системой, на одном и том же материале.
Что измерять — тоже важно, и здесь легко сбиться на один-единственный процент. Нужен набор показателей: recall по классам ошибок отдельно от общего; recall критичных ошибок — он важнее всего; precision — сколько из срабатываний системы оказались настоящими ошибками, а не ложными тревогами; время и стоимость проверки; доля случаев, в которых система честно не может сделать обоснованный вывод; ожидаемый остаточный ущерб; и, наконец, совокупный экономический эффект по формуле из третьего раздела.
На отдельном пункте стоит остановиться — это способность системы отказаться от необоснованного заключения. Сообщение «не найден применимый норматив» или «требуется экспертное подтверждение» — это не провал, а правильный результат работы. Система, которая уверенно отвечает всегда, в том числе когда основания нет, опаснее системы, которая умеет сказать «не знаю» и передать случай человеку. В метриках это отражается как доля «нерешённых» случаев, и её нужно отслеживать отдельно — если она растёт, это сигнал, а не проблема, но и слишком высокая доля означает, что автоматизация не состоялась.
Ещё один момент: пилот стоит заканчивать не выводом «система хорошая», а числами, на которые можно опереться в решении о масштабировании. Если recall критичных ошибок высок, ложных срабатываний мало, а доля нерешённых случаев не растёт — это одна картина. Если система ловит только очевидное, а всё важное уводит в «требуется эксперт», — это другая, и она честно говорит, что автоматизации пока не получилось и нужна доработка. Хороший пилот — не демонстрация успеха, а измеритель, который не даёт выдать надежды за результаты.
Где требование почти абсолютной надёжности действительно оправданно?
До сих пор мы говорили о том, почему требование ста процентов чаще всего избыточно. Но было бы ошибкой вывернуть это в противоположную крайность и начать относиться к критичным ошибкам легкомысленно. Есть случаи, где пропуск одного-единственного дефекта действительно неприемлем: когда ошибка может привести к аварии, нарушению обязательных нормативных требований, угрозе безопасности людей или чрезвычайно крупным потерям.
Для таких классов риска средний экономический эффект — недостаточное основание для решения. Здесь нужны другие механизмы: обязательная экспертная проверка, независимые контуры контроля, формальные правила, запрещающие автоматическое принятие решения, защитные барьеры, которые срабатывают, даже когда всё остальное ошибается. Стоимость этих барьеров не обязана «окупаться» в обычном смысле — она платится за то, что недопустимое событие не произойдёт.
Какими эти барьеры бывают на практике, зависит от области. В строительстве критичные решения — несущие конструкции, пожарная безопасность, дорогостоящие системы — могут требовать подписи главного инженера, независимой проверки расчётов, формального согласования изменений проектной документации. Система в таких местах не принимает решение сама, а готовит материалы для человека и фиксирует, что требуемая проверка выполнена. Её роль — не заменить барьер, а сделать так, чтобы его нельзя было обойти по невнимательности.
И здесь важно не спутать два разных утверждения. Одно — «система не гарантирует 100% обнаружения всех возможных ошибок». Это справедливо практически всегда и почти всегда не является основанием для отказа. Другое — «система не обеспечивает требуемую надёжность для конкретного критичного класса дефектов». Вот это уже может быть настоящим блокером, и его нужно проверять отдельно, смотря не на общий процент, а на поведение системы именно на этом классе.
Разница принципиальная. Первое утверждение — про неизбежный остаточный риск, с которым бизнес и так живёт. Второе — про конкретную границу, ниже которой опускаться нельзя. Зрелый подход умеет отличать одно от другого и не позволяет разговору про «100% вообще» подменять проверку того, что действительно критично.
Именно поэтому на вопросе заказчика «а если она пропустит ошибку, из-за которой рухнет конструкция» правильный ответ — не «процент обнаружения у нас высокий», а разбор: для этого класса дефектов у нас отдельный барьер, обязательная экспертная проверка и формальное правило, и система не принимает такое решение автоматически. Требование надёжности для критичного класса — это не «100% по всему потоку», а конкретный проверяемый барьер на конкретном месте. Смешивать эти два уровня — самая частая ошибка в разговоре, и из-за неё либо отказываются от полезного инструмента, либо, наоборот, доверяют системе там, где доверять нельзя.
Заключение
Вернёмся к вопросу, с которого всё началось: «А если она пропустит пять процентов ошибок?» Правильный ответ — не «не пропустит, она хорошая» и не «значит, не внедряем». Правильный ответ: давайте посмотрим, сколько ошибок пропускает текущий процесс, сколько они стоят и что изменится после внедрения.
Зрелый подход к внедрению ИИ начинается не с вопроса «может ли технология гарантировать 100%?», а с цепочки других вопросов. Какой риск существует сейчас? Какие потери мы несём? Что именно изменит новая система? Как мы измерим этот эффект? Какие риски останутся — и какие барьеры для них необходимы?
Ответы на эти вопросы почти никогда не требуют от системы абсолютной безошибочности. Они требуют, чтобы система снижала ожидаемые потери, делала процесс контроля дешевле и однороднее, умела честно отказываться от необоснованного заключения и оставляла за человеком то, что действительно требует его суждения.
Итоговая мысль проста. Интеллектуальная система контроля не обязана заменять эксперта — и не должна этого обещать. Её ценность в другом: она повышает результативность всего процесса, сочетая ИИ, детерминированные механизмы, доказательную базу и риск-ориентированное участие человека. Миф о ста процентах — это не причина отказываться от инструмента, а симптом того, что мы ещё не сформулировали, чего на самом деле хотим от контроля: не «чтобы не было ошибок», а «чтобы ошибки обходились нам приемлемо и с каждым кварталом дешевле».